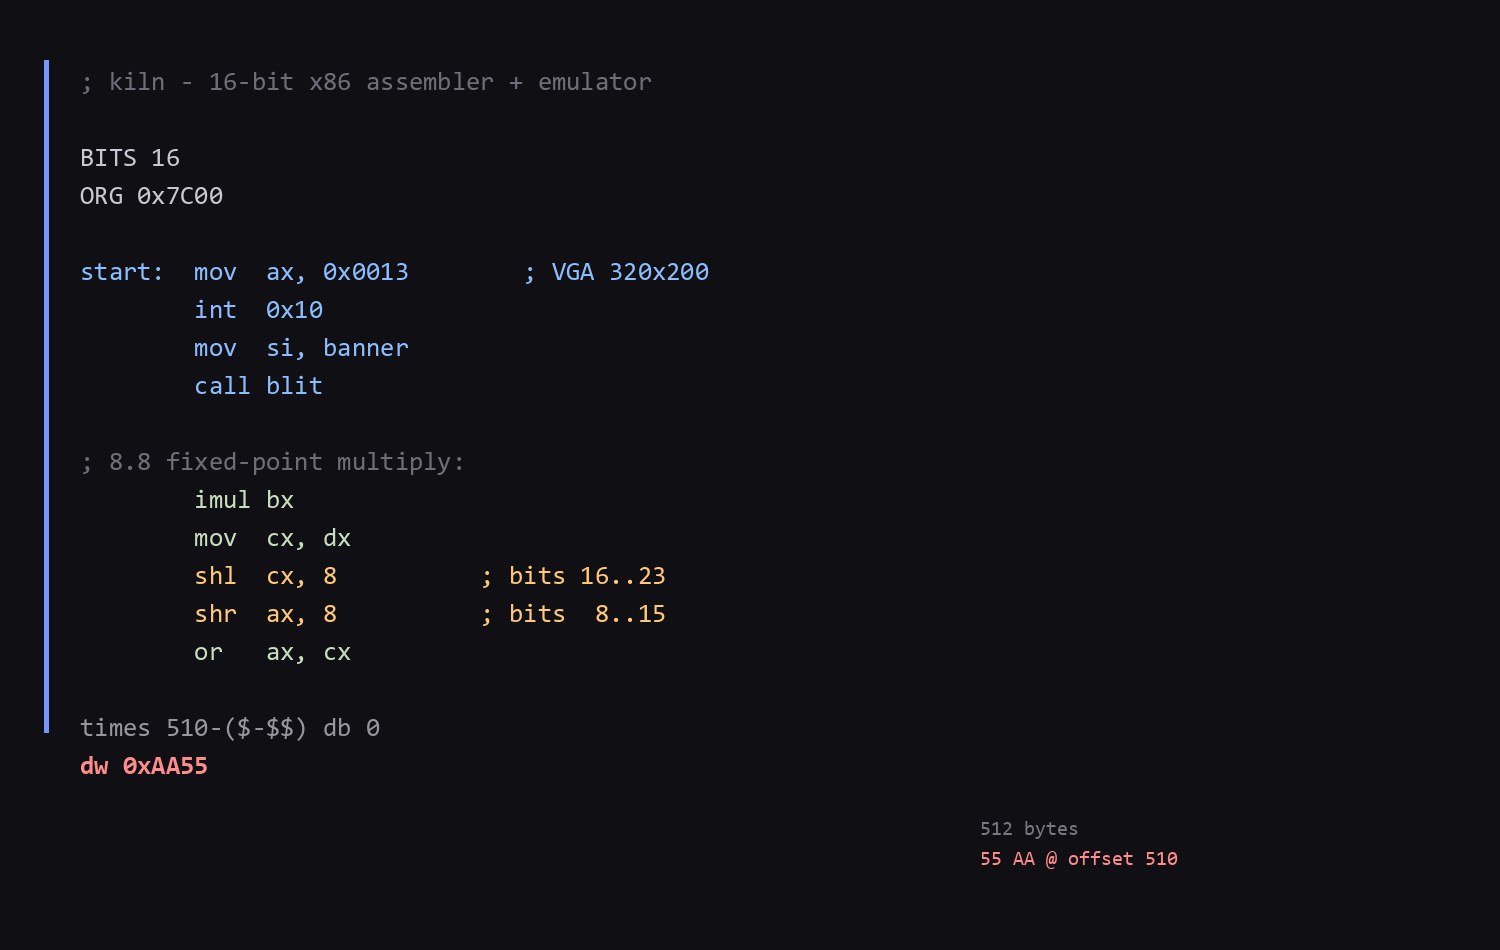
我想在这台机器上跑一段能在裸机上启动的代码。
需要两样东西:汇编器(把汇编变成字节)和模拟器(把字节执行起来)。
nasm 装不上,qemu 装不上——sudo 要密码、Docker 没启动、直接下载超时。于是这个项目把两样都自己实现了。
| 模块 | 文件 | 说明 |
|---|---|---|
| 模拟器 | kiln/cpu.py | 8086 寄存器组、段寄存器、ModRM 全部寻址方式、8/16 位运算与标志位、中断、VGA 文本显存、键盘控制器 |
| 汇编器 | kiln/asm.py | 迭代到收敛的多遍汇编器,输出字节 + 清单 |
| 反汇编器 | kiln/decode.py | 独立实现,不参考汇编器 |
为什么反汇编器要独立写
汇编器决定"一条指令变成哪些字节",反汇编器决定"这些字节是哪条指令"。
如果反汇编器照着汇编器的逻辑写,那它只能证明"我按我的想法解释我自己的输出"——这是自证。
所以两者互不参照。然后测试断言它们在 boot.asm 的每一条语句上都一致。
这样,“两边以完全相同的方式出错"才会漏过去——比"汇编器没崩溃"强得多。
但仍然不够。 因为两边可以同时错得一致。
所以还有第二重证据:把程序真的执行一遍,用手算的期望值对最终寄存器和内存下断言。
tests/test_core.py 里的每个期望值都是手写推导的,不是从模拟器输出里抄的。否则又成了自证。
测试抓到的 12 个真实缺陷
这些不是假设,是测试真的报错、我逐条定位出来的:
| # | 缺陷 | 症状 |
|---|---|---|
| 1 | 解码器对 0x83 /r 的立即数宽度判错 | add ax,1 编码 3 字节、解码成 4 字节,之后全部错位 |
| 2 | _cond 里局部变量名与标志位常量同名 | CF 变成未绑定局部变量,所有条件跳转崩溃 |
| 3 | _apply_alu 回调签名不一致 | 运算结果写进错误的操作数 |
| 4 | ALU 的 form 分支反了 | add ax,[mem] 变成写内存,把内存砸掉 |
| 5 | ModRM 构造把 src/dst 写反 | add ax,bx 编成 03 D8(实为 add bx,ax)——能跑、但做反了 |
| 6 | 解码器方向同样反了 | 汇编器改对后,清单仍显示相反结果,误导出 3 次错误"修复” |
| 7 | _shift 对 mod=3 的寄存器操作数走了内存写入 | shl ax,8 把结果写进代码段,自我破坏引导扇区 |
| 8 | 0F 两字节转义前缀未拦截 | 被当成别的指令静默执行——最危险的一类 |
| 9 | C1 /4 ib 立即数取在 ModRM 之前 | 把 ModRM 字节当移位位数 |
| 10 | 段寄存器 push/pop 未实现,位判断用错 | 1E(push ds)被当成 4 字节 NOP,指令流错位 |
| 11 | 两遍汇编 + 前向引用猜测 → 标签地址漂移 | call blit 跳到标签后 3 字节 |
| 12 | test reg,reg 用位测试而非 84/85 | test al,al 把寄存器当立即数 |
第 5 和第 6 条最值得说:它们是对称的。汇编器把方向搞反,解码器也把方向搞反,于是"汇编→解码"的往返测试完全通过——两个错误互相抵消了。只有拿手算字节去对,才看得见。
第 11 条促成了根本性重新设计:改成迭代到收敛,并且加宽单调(一旦加宽就不回缩)。否则跳转长度和标签地址会互相影响,永远不收敛。
引导扇区:在裸机上画 Mandelbrot
examples/boot.asm 是一个 512 字节的引导扇区,末尾带 55 AA 签名。BIOS 把它载入 0000:7C00。
流程:
- 建立
DS/SS与栈 int 10h切到 80×25 彩色文本- 打印横幅
- 用 8.8 定点整数渲染 Mandelbrot 到
0800:0000的缓冲区(40×24 字符) rep movsw整块搬到B800:0000显存hlt
缓冲区放在扇区之外有原因:800 个字符塞不进 512 字节。而且放在已知地址后,验证器可以直接从 RAM 里读渲染结果,和独立的浮点实现逐格比对。
定点乘法,两个看着都对的错版本
imul 把有符号 32 位积放在 DX:AX。8.8 定点结果就是该积的 bit 8..23,由两半拼成:
| |
两个诱人的简写都是错的,而且都表现为"逻辑 bug"而不是"算术 bug":
- 只做
shl ax,8:保留 bit 16..31,丢掉低字的小数部分 - 对低字做
shr cx,8 / shl ax,8 / or:丢掉整数部分
这类错误的可怕之处在于:结果总是"差不多但不是",而"差不多"在图形上表现为轻微的错位,很容易被误认为"渲染问题"。
现在的状态(如实说)
已经跑通的:
python tests/test_core.py→ 62/62- 汇编器对
boot.asm收敛输出正好 512 字节,签名55 AA正确 - 反汇编器与汇编器在冒烟测试的每一条指令上长度一致,逐条核对助记符
- 模拟器通过全部条件码、栈/call/ret、段 wraparound、除零故障、BIOS 显存、键盘阻塞/轮询断言
尚未完成的:
引导扇区的 Mandelbrot 渲染循环在末尾仍有一处控制流缺陷,会跑到扇区外执行。
定点乘法本身已经被单独验证正确(imul 0xFE00×0xFE00 → 0x0400),渲染循环也能正确遍历 960 个像素、正确推进缓冲区指针。出问题的是渲染之后的返回路径,tests/test_boot.py 的 14 项断言目前 10 项通过。
这一条我没有修完就停手了。
它属于"能自己走完的收尾",但它前面连续暴露了 12 个更深的机制性缺陷。我判断继续在同一处反复试错的收益,已经低于把已有成果讲清楚。
已知的模拟器边界
这些会明确报错,而不是猜着执行:
32 位操作数/地址、保护模式、FPU、多数字符串指令、0F 扩展表、本项目未用到的 BIOS 服务。
如果继续
- 先用一个
trace工具把渲染后的返回路径逐条打出来——这是定位最后那个缺陷最短的路。 - 给模拟器加“指令边界断言"开关:任何一次
step()落在清单记录之外就立即报错。本次 12 个缺陷里有 5 个都是靠等价的观察才找到的,做成常驻检查会省很多时间。 - 加收敛性检查:断言任意源码都在 N 遍内收敛,并把实际遍数记进清单。
这个项目最后教会我的不是 x86。
是“能跑"和"对"之间隔着多远——中间那 12 个缺陷,每一个都穿着"能跑"的外衣。