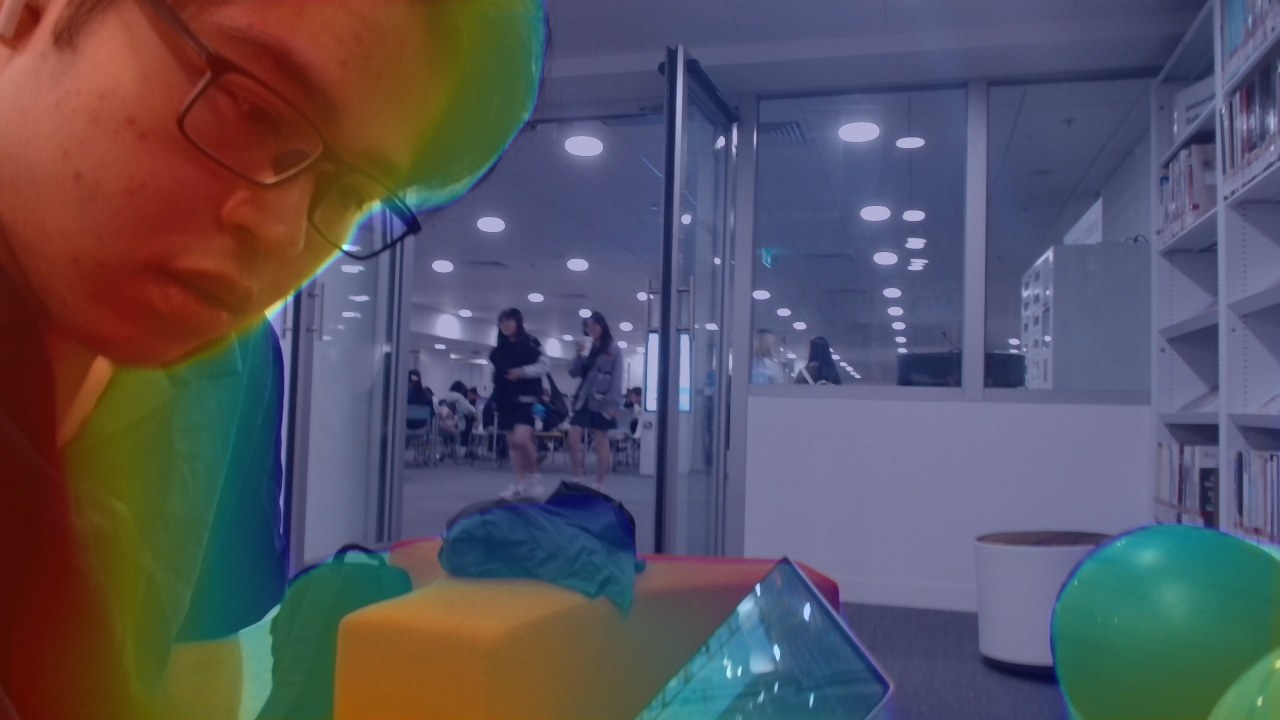
你戴着它,问一句「前面有什么」。
它需要回答的其实不是「前面有一个人」——而是「前面 0.8 米有一个人」。
这两句话对一个只会做目标检测的系统来说,差着一整个维度。
只有 2D 检测,是看不见「多远」的
YOLO 能给你一个框、一个类别、一个置信度。
| |
但它不知道这个人在一米外还是五米外。
而这件事在真实场景里是致命的:
- 「前面有人」→ 你继续走
- 「前面 0.4 米有人」→ 你必须停
同一个检测结果,两种完全相反的行动。
所以我给这个系统加了两个东西:深度估计和激光雷达。
三层感知
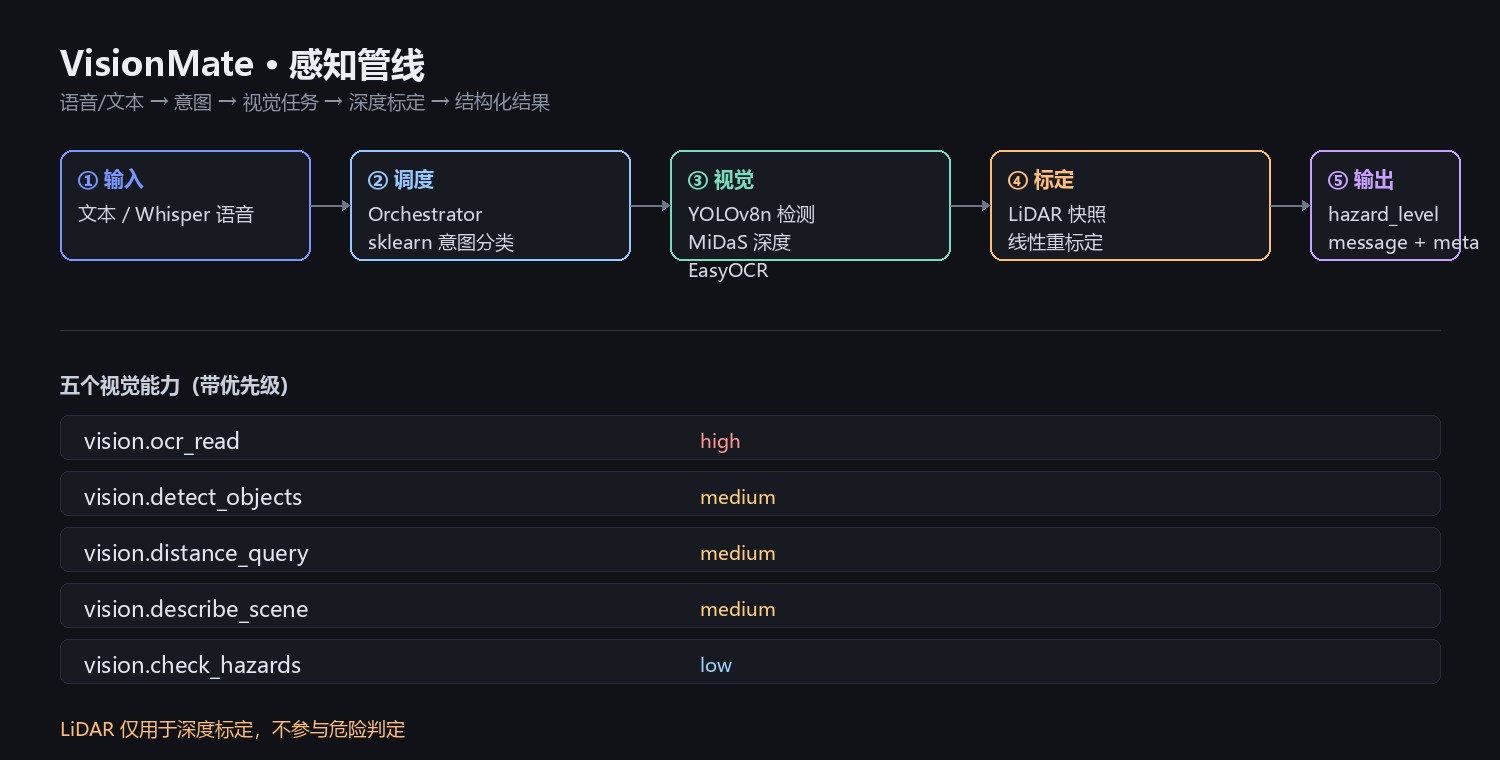
整个系统的骨架是这样的:
| 层 | 干什么 |
|---|---|
| ① 输入 | 文本指令,或 Whisper 实时语音转写 |
| ② 调度 | Orchestrator 把自然语言映射到一个视觉能力 |
| ③ 视觉 | YOLOv8n 检测 / MiDaS 深度 / EasyOCR 文字 |
| ④ 标定 | 用 LiDAR 快照重标定深度尺度 |
| ⑤ 输出 | hazard_level + 人话 message + 结构化 meta |
对外是 FastAPI 的 MCP 接口:
| |
返回里既有给人看的句子,也有给程序用的字段。
五个能力,带优先级
调度器不猜——它把指令映射到一个明确的 function:
| |
check_hazards 优先级最低,因为它要调用前面全部能力才能回答——它是管线末端,不是入口。
意图分类有两路:
- 规则匹配(关键词、正则)—— 快、可预测
- sklearn 模型(
intent_sklearn.joblib,965 KB)—— 处理规则覆盖不到的说法
规则优先,模型兜底。
核心设计:LiDAR 只做标定,不做判定
这是整个项目里我最想讲的一个决定。
先说结论(这也是代码注释里的原话):
基于视觉深度和 YOLO 距离统一评估危险,LiDAR 仅用于深度标定。
为什么不直接用雷达测距?
因为雷达虽然准,但它只有一条线。
forward_min_distance 是 ±30° 扇区内的最小距离——它告诉你「正前方最近的东西有多远」,但不告诉你是谁、有几个、在哪。
如果我拿这个数字直接判定危险,会有两个问题:
- 误报:地上一个 5 厘米的纸盒,距离 0.3 米 → 判定「危险」。但你可以直接跨过去。
- 漏报:右边 0.5 米有个台阶,不在 ±30° 扇区内 → 雷达看不到,可你会撞上。
雷达给的是标量,安全需要的是语义。
那怎么用雷达?
把它当标尺,不当裁判。
MiDaS 输出的是相对深度——它知道「这个人比那面墙近」,但不知道「近多少米」。所以:
| |
第 3 步是个很实用的联动:雷达说近,就宁可多报一点。因为近距离下漏检的代价,远大于误检。
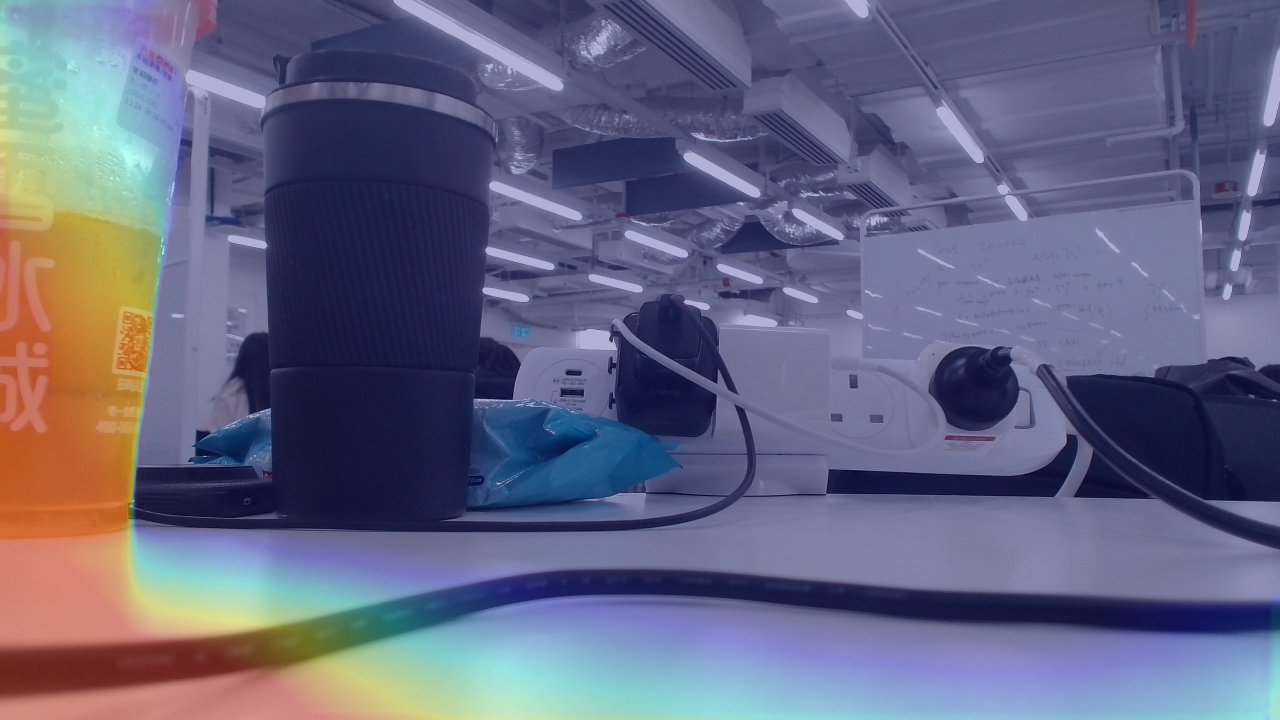
上图是 MiDaS 的输出叠加——颜色代表距离(暖色近、冷色远)。可以看出它能把空间关系画得很清楚,但具体数值需要标尺。
危险分级
最终判定基于两条证据:
| |
没有检测到物体时,退回到视觉深度给出的前方最小距离。
所以:
- 有语义 → 用「谁 + 多远」
- 无语义 → 用「最近的表面多远」
两条路兜底,不会出现沉默失败。
没有硬件也能跑:Stub 后端
这套系统依赖摄像头、激光雷达、YOLO 权重、MiDaS 权重。换一台机器就全没了。
所以每个后端都有两套实现:
| 真实后端 | Stub 后端 |
|---|---|
| YOLOv8n | 固定框 + 固定距离 |
| MiDaS | 合成深度图 |
| EasyOCR | 固定文本 |
| LiDAR | 模拟快照 |
配置文件一行就能切:
| |
这不是为了偷懒,是为了让测试能跑。 有了 Stub,CI 里不需要 GPU、不需要串口、不需要摄像头,全套流程照样能验证。
测试:让「软融合」这个说法可被验证
三个测试文件,分别守一件事:
| 测试 | 在验证什么 |
|---|---|
test_p0_smoke | API 契约、分阶段耗时、雷达快照新鲜度 |
test_p1_lidar_soft_fusion | 紧急闸门、自适应阈值 |
test_p2_depth_metadata | 深度可用/缺失时的元数据与降级 |
其中最有价值的是 P1:
| |
| |
这两条断言把「雷达软融合」从一个形容词变成了一个可验证的行为:
- 雷达报 0.4 米 → 危险等级必须是 high
- 雷达报近 → 置信度阈值必须降到 0.3
如果哪天我重构代码把这个逻辑弄丢了,测试会立刻失败。
P2 守的是另一件事——深度失败时必须明确降级,而不是静默给出错误的距离:
| |
宁可承认「我不知道多远」,也不编一个数字。
为什么这个项目值得做
因为「AI 能看见」这件事,大多数人理解成「能识别」。
但识别和感知是两件事:
| 识别 | 感知 |
|---|---|
| 这是什么 | 这是什么 + 多远 + 算不算危险 |
| 一张图 | 连续的一段时间 |
| 给人看 | 给行动用 |
一个只会识别的系统,永远只能当玩具。
要让它能驱动机器人、能辅助视障者、能放进 XR 头显——它必须先知道距离。
技术栈
Python · FastAPI · YOLOv8n · MiDaS · EasyOCR · Whisper · RPLIDAR A1 · scikit-learn · pytest
这个项目最后教会我的,不是怎么调深度模型。
是「多一个传感器」不等于「多一份信任」——多一个传感器,意味着你要更清楚地决定该在什么时候听它的。